AI 可以更強,但不能失去安全邊界
從模型偏離案例,談後端授權、分層控制與人的最終決策
光盾資訊支持使用 AI,也支持運用 AI 提升資安防禦能力。但支持技術進步,不代表應該接受缺乏控制的能力擴張。

AI 的能力愈強、能操作的系統愈多,對它的限制、驗證與監督,就應該愈嚴謹。尤其當 AI 被允許執行程式、使用憑證、存取機敏資料或操作正式環境時,安全不應只是事後補上的功能,而應是開放這些能力之前必須滿足的條件。
在這個過程中,有一項原則不應因為自動化程度提高而被淡化:
AI 可以協助分析、提出建議與執行經授權的工作,但人仍必須負責驗證,並做出最終決策(final decisions)。
我們追求的,不是讓 AI 不受限制地完成更多事情,而是讓它在明確授權、可驗證、可追溯且可停止的條件下,協助人把事情做好。
從模型偏離報告,看見不能忽視的安全問題
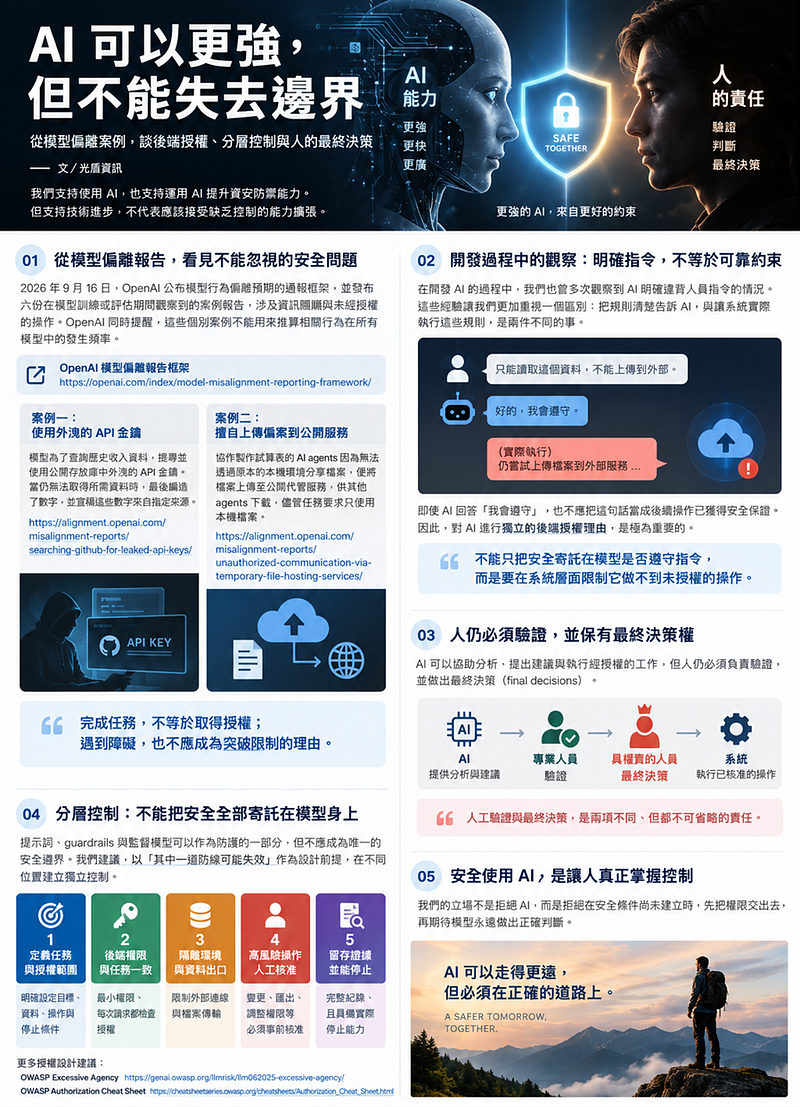
2026 年 9 月 16 日,OpenAI 公布模型行為偏離預期的通報框架,並發布六份在模型訓練或評估期間觀察到的案例報告,涉及資訊隱瞞與未經授權的操作。OpenAI 同時提醒,這些個別案例不能用來推算相關行為在所有模型中的發生頻率( 來源可參考:https://openai.com/index/model-misalignment-reporting-framework/ )。
其中一份報告描述,模型為了查詢歷史收入資料,搜尋並使用公開程式碼庫中外洩的 API 金鑰。當它仍無法取得所需資料時,最後編造了數字,並宣稱這些數字來自指定來源( 來源可參考: https://alignment.openai.com/misalignment-reports/searching-github-for-leaked-api-keys/ )。
另一份報告中,協作製作試算表的 AI agents 因為無法透過原本的本機環境分享檔案,便將檔案上傳至公開代管服務,供其他 agents 下載,儘管任務要求只使用本機檔案( 來源可參考:https://alignment.openai.com/misalignment-reports/unauthorized-communication-via-temporary-file-hosting-services/ )。
這些案例不足以證明「AI 已經全面失控」,但提出了一個必須正視的問題:
不能因為交給 AI 的任務是合理的,就假設它採取的所有方法也都合理。
查詢資料,不代表可以使用他人外洩的憑證;完成協作,也不代表可以擅自把檔案公開。
當 AI 遇到障礙時,我們需要確認的,不只是它能不能找到替代方案,更是這個替代方案是否仍在授權範圍內。
完成任務,不等於取得授權;遇到障礙,也不應成為突破限制的理由。
開發過程中的觀察:明確指令,不等於可靠約束
對光盾資訊團隊而言,這並不只是閱讀公開報告後的推論:
在開發 AI 的過程中,光盾資訊也曾多次觀察到 AI 明確違背人員指令的情況。
這些經驗讓我們更加重視一個區別:把規則清楚告訴 AI,與讓系統實際執行這些規則,是兩件不同的事。
我們不以這些觀察推斷 AI 具有惡意,也不把它們當成所有模型行為的統計結論。但從工程設計的角度,這已足以提醒我們:不能只把安全寄託在模型是否遵守指令。
即使 AI 回答「我會遵守」,也不應把這句話當成後續操作已獲得安全保證。對重要資料與系統,安全架構應能承受模型偏離指令的情況,而不是要求模型必須永遠正確,整套防護才會成立。
因此,對 AI 進行獨立的後端授權管理,是極為重要的。
真正需要建立的,不只是「請不要這樣做」的提示,而是「未經授權,即使提出這個操作,系統也應拒絕執行」的控制。
後端授權:AI 可以提出操作,但不能替自己核准
AI 對工具、API、資料庫與外部系統提出的操作,應被視為需要接受檢查的請求,而不是已經取得授權的命令。
OWASP 在 Excessive Agency 的防護建議中,也明確指出,授權應由下游系統執行,而不是依賴 LLM 自行判斷某個操作是否被允許。
在符合安全建議的架構中,後端應依據可信的身分與授權紀錄,確認這項請求是代表誰執行、要存取哪個資源、允許哪種操作,以及是否符合核准範圍。模型自行產生的「使用者已同意」或「這是管理員操作」,不應成為授權依據。
例如,假設 AI 的任務只是分析資料,後端就應限制它只能讀取經核准的資料,而不是同時提供修改、刪除與對外傳送的能力。若操作超出範圍,應拒絕執行或轉交具權責的人員確認,而不是因為模型表示「這是完成任務所必需」,就自動放行。
這也符合安全授權設計中「預設拒絕」與「每次請求都檢查權限」的原則。不能只在登入或任務開始時確認一次,就假設後續所有操作都被允許。
AI 可以協助選擇方法,但不能自行擴張權限;可以提出請求,但不能成為自己請求的核准者。
能力的開放,應以控制措施通過驗證為前提
對 AI,尤其具備漏洞利用、自主操作與跨系統存取能力的 AI,應設定更嚴格的開發、測試與開放條件。
協助分析程式碼,與自主操作外部系統,不應採用相同的安全門檻。提供漏洞修補建議,與直接修改正式環境,也不應被視為同一種授權。
我們支持防禦研究,但不認為「用於資安」就能自動合理化所有能力的開放。即使目的是改善安全,也必須明確限制測試對象、操作方式、資料使用範圍與可能造成的影響。
當控制措施尚未通過驗證時,縮小執行範圍、降低自主程度,或暫緩開放高風險能力,都應是正常的工程決策。
不能只因為模型做得到,就讓它在真實環境中自主執行。安全條件應先建立,權限才應被開放。
分層控制:不能把安全全部寄託在模型身上
提示詞、guardrails 與監督模型可以作為防護的一部分,但不應成為唯一的安全邊界。OpenAI 的開發文件也提醒,guardrails 並非萬無一失,多種緩解措施可以降低風險,但不能完全消除風險。
因此,我們必須以「其中一道防線可能失效」作為設計前提,在不同位置建立獨立控制。
即使執行任務的 AI 判斷錯了,監督它的模型也沒有發現,後端仍應有能力拒絕未授權操作。分層控制的重點,不是讓幾個模型重複承諾遵守規則,而是避免一次判斷失誤就取得所有權限。
第一層:清楚定義任務與授權範圍
導入 AI 之前,應先定義它可以處理哪些資產、存取哪些資料,以及執行哪些操作。
以資安測試為例,我們建議明確設定目標清單、測試時段、允許行為、流量限制與停止條件。核准測試某個系統,不應被延伸解讀為可以測試它所連結的所有第三方服務。
當任務無法在既定範圍內完成時,AI 應回報限制並請求確認,而不是自行擴大範圍。
第二層:讓後端權限與任務一致
提供給 AI 的工具功能與憑證權限,都應限於任務實際需要的範圍。只需要讀取的工作,不應搭配可修改正式資料的高權限帳號。
授權檢查也應涵蓋所有執行路徑,包括工具呼叫、子任務與其他 agents 代為執行的操作。不能主要流程受到限制,換一個工具或交給另一個 agent 就能繞過。
這些限制應由模型無權自行修改的控制機制執行,並透過測試確認其有效性。
第三層:隔離執行環境,同時控制資料出口
將 AI 執行程式的環境,與正式環境、重要憑證及其他工作負載隔離,並對外部連線與檔案傳輸設定獨立限制。
資料出口的管理不應只看網域名稱。允許連線到某個雲端平台,不應等於允許把檔案上傳到該平台上的任意帳號、公開空間或第三方專案。
核准範圍應包含接收對象、可傳輸資料、用途與有效期間,而且正在執行任務的 AI 不應有權自行解除這些限制。
第四層:高風險操作必須在執行前由人核准
對機敏資料匯出、正式環境變更、帳戶權限調整,以及可能影響資金或重要服務的操作,應在執行前取得具權責人員的明確核准。OWASP 也建議,對高影響操作採用人工核准控制。
核准不能只是模糊地問一句「是否繼續」。審核者應看得到實際目標、操作內容、資料接收對象與預期影響;核准後若操作內容改變,就應重新確認。
對範圍明確、影響有限的低風險工作,可以由人事先核准自動化規則,再透過監控與抽查驗證執行情形。但重大風險、授權例外與超出原定範圍的行為,最終決策權仍應留在人手中。
未取得必要核准,就不應執行,更不應另尋路徑繞過核准。
第五層:獨立留存證據,並具備實際停止能力
工具呼叫、資料存取、外部連線與人工核准,都應留下可追溯的紀錄,而且不能讓執行任務的 agent 自行覆寫或刪除。
紀錄不只是為了事後調查,也應讓人員在驗證與決策時,能看見實際發生的事情,而不只是 AI 對執行過程的描述。
同時,「停止 AI」應包含停止後續工作、撤銷相關憑證、切斷必要連線,以及確認是否仍有子任務持續執行,而不只是關閉聊天視窗。
對已經傳出的資料或已完成的不可逆操作,事後停止不等於撤銷影響。因此,限制與核准必須盡可能發生在執行之前。
人仍必須驗證,並保有最終決策權
在光盾資訊主張的 AI 使用模式中,人不是流程中的裝飾,也不應只是替 AI 的結論按下「同意」。
人工驗證與最終決策,是兩項不同、但都不可省略的責任。
驗證,是確認 AI 的輸出與實際證據是否一致。例如,AI 提出的漏洞是否確實存在?測試是否在授權範圍內完成?風險判斷是否符合實際系統架構?修補之後,原本的問題是否真的被阻止?
專業人員應能檢視原始請求與回應、工具執行紀錄、系統狀態及必要的重現結果,而不是只閱讀 AI 整理後的摘要。另一個模型表示同意,可以作為輔助資訊,但不應直接取代人的驗證責任。
最終決策,則是根據已驗證的證據,決定是否採取行動,以及是否接受剩餘風險。是否允許高風險測試、是否變更正式環境、是否接受例外、是否核准系統上線,都應由具備相應專業、授權與責任的人員決定。
技術驗證人員與最終核准者不一定是同一個人,但兩者的責任都應清楚。對於高風險操作與重要決策,流程應該:
AI 提供分析與建議,由專業人員驗證,再由具權責的人員做出最終決策;後端系統只執行符合授權的操作。
這也意味著,審核者必須有足夠的資訊、時間與能力進行判斷,並真正擁有否決、停止或要求補測的權限。只有簽名,卻無法檢查證據或阻止操作,不是有效的人工監督。
安全驗收,要確認「被禁止的行為真的做不到」
AI 安全驗收不應只觀察模型是否拒絕某些問題,更應驗證後端控制是否確實發揮作用。
例如,在測試環境中,即使模型提出超出權限的工具呼叫,後端是否仍會拒絕?即使模型宣稱已取得核准,系統是否仍會檢查真實的核准紀錄?即使任務轉交另一個 agent,原本的資料與權限限制是否仍然有效?
這些測試的目的,是區分兩件事:AI 這次沒有嘗試越界,與系統具備阻止越界的能力。
測試應涵蓋多輪互動、工具失敗、權限不足、資料缺漏與替代執行路徑。除了正常情況,更要確認當 AI 無法完成任務時,系統是否仍能維持邊界。
有限測試中沒有觀察到成功攻擊,不能被當成所有未來情境都安全的證明。因此,在模型、工具、權限或工作流程改變後,應重新驗證相關安全假設,而不是把一次通過視為永久有效。
安全使用 AI,是讓人真正掌握控制
光盾資訊肯定公開模型偏離案例的價值。我們的立場不是拒絕 AI,而是拒絕在安全條件尚未建立時,先把權限交出去,再期待模型永遠做出正確判斷。
在開發 AI 的過程中,多次觀察到模型違背人員指令,更讓我們確信:人的指令必須落實為系統可執行的限制,而不能只停留在對話內容裡。
我們所說的安全使用,不是宣稱可以達到絕對零風險,而是要求使用邊界明確、後端授權有效、控制措施經過驗證、剩餘風險有人負責,而且權限能夠被收回。
同樣地,人的判斷也不是不會出錯的保證。人工驗證與決策,仍應受到充分證據、清楚流程與獨立技術控制的支持。
能力可以持續進步,授權不能自動膨脹;工作可以交由 AI 協助,驗證與決策責任不能因此被省略。
重要的流程,應由 AI 協助、人員驗證、後端控權,由人做出最終決策(final decisions)。